anúncios

terça-feira, 25 de outubro de 2016

Instalando PHP 7 no Linux

O presente post, mostra os procedimentos para instalar o PHP 7 (lançado oficialmente em 2016), juntamente com o servidor Apache e o SGBD MySQL nas distros Ubuntu, Debian 8.x e CentOS 7.x
Observação: Não pode ter o PHP 5.x instalado, antes de seguir os procedimentos abaixo deve remover por completo o PHP 5.x, pois ocorre conflito. Para isso, basta executar no Debian e Ubuntu # apt-get purge php5-*
Segue os procedimentos conforme a distribuição Linux adotada:

No Ubuntu


sudo apt-get update
sudo apt-get install ca-certificates apache2 libapache2-mod-php php-cli php php-curl php-apcu php-gd php-imap php-ldap php-mysql php-cas php-soap php-mbstring php-xml php-xmlrpc mariadb-server


No Debian
Adicionar no arquivo /etc/apt/sources.list as linhas abaixo
deb http://ftp.br.debian.org/debian/ stable main contrib non-free
deb-src http://ftp.br.debian.org/debian/ stable main contrib non-free

deb http://ftp.br.debian.org/debian/ stable-updates main contrib non-free
deb-src http://ftp.br.debian.org/debian/ stable-updates main contrib non-free

deb http://security.debian.org/ stable/updates main contrib non-free
deb-src http://security.debian.org/ stable/updates main contrib non-free


Atualiza do repositório e instala os pacotes que compõe o ambiente de desenvolvimento web completo
# apt-get update
# apt-get install ca-certificates apache2 libapache2-mod-php php-cli php php-curl php-apcu php-gd php-imap php-ldap php-mysql php-cas php-soap php-mbstring php-xml php-xmlrpc mariadb-server


No RHEL/CentOS 7.x
No CentOS 7.x, foi adotado o SGBD MariaDB (fork do MySQL)
yum install httpd mariadb mariadb-server
rpm -Uvh https://dl.fedoraproject.org/pub/epel/epel-release-latest-7.noarch.rpm
rpm -Uvh https://mirror.webtatic.com/yum/el7/webtatic-release.rpm
yum install php70w


Feito!

sábado, 22 de outubro de 2016

Configurando RAID via software no Debian

Depois de conhecer o RAID e pra que ser serve no post anterior Entendendo RAID , podemos seguir os procedimentos de configuração do RAID via software em seu computador com SO GNU/Linux Debian Jessie, mas deve funcionar também em outra distro sem problemas, basta substituir pelo gerenciador de pacotes da distro que esta usando atualmente.
A ferramenta de gerenciamento RAID via software é mdadm, que poderá ser instalado facilmente por meio do gerenciador de pacotes da sua distro. No presente post, será utilizado o GNU/Linux Debian 8.5.
Primeiramente atualizando o repositório
root@Saitam:~# apt-get update
Instalação da ferramenta mdadm
root@Saitam:~# apt-get install mdadm
Sintaxe do mdadm:
mdadm [modo] [nome-array] [opções] [componentes-array]
O procedimento abaixo é apenas para fins didáticos como exemplo, nesse caso poderá ser usado uma máquina virtual e adicionar dois discos de 1GB ou outro tamanho, desde que os dois discos sejam de mesmo tamanho.
Após criar os 2 discos na máquina virtual em VirtualBox ou VMWare, segue os procedimentos abaixo:

RAID 0 e 1 via software
1. Criar partições nos discos
Verifique qual a nomenclatura do seu disco que foi usada com # fdisk -l
No presente exemplo foram: /dev/sdd e /dev/sde
Verificação dos discos a ser criados as partições
root@Saitam:~# fdisk -l /dev/sdd
Disk /dev/sdd: 1 GiB, 1073741824 bytes, 2097152 sectors
Units: sectors of 1 * 512 = 512 bytes
Sector size (logical/physical): 512 bytes / 512 bytes
I/O size (minimum/optimal): 512 bytes / 512 bytes
root@Saitam:~# fdisk -l /dev/sde
Disk /dev/sde: 1 GiB, 1073741824 bytes, 2097152 sectors
Units: sectors of 1 * 512 = 512 bytes
Sector size (logical/physical): 512 bytes / 512 bytes
I/O size (minimum/optimal): 512 bytes / 512 bytes


Disco 1: root@Saitam:~# cfdisk /dev/sdd
Criação da partição selecionando tipo fd (Linux RAID) no disco /dev/sdd

Disco 2: root@Saitam:~# cfdisk /dev/sde
Criação da partição selecionando tipo fd (Linux RAID) no disco /dev/sde

2. Criar o Array RAID
root@Saitam:~# mdadm -v -C /dev/md0 --chunk=64 --level=1 --raid-devices=2 /dev/sdd1 /dev/sde1

3. Adicionar o Array RAID no arquivo /etc/mdadm/mdadm.conf
root@Saitam:~# mdadm -Es | grep md >> /etc/mdadm/mdadm.conf

4. Criar o sistema de arquivos para o RAID criado. No caso será criado o sistema de arquivos ext4.
root@Saitam:~# mkfs.ext4 /dev/md0

5. Montar o Array RAID no /mnt/raid
root@Saitam:~# mkdir /mnt/raid
root@Saitam:~# mount -t ext4 /dev/md0 /mnt/raid


6. Adicionar no arquivo /etc/fstab
root@Saitam:~# echo "/dev/md0 /mnt/raid ext4 defaults 0 0" >> /etc/fstab

7. Verificar o ponto de montagem
root@Saitam:~# df -h

8. Verificar o funcionamento do arranjo RAID

root@Saitam:~# mdadm --detail /dev/md0
OU
root@Saitam:~# cat /proc/mdstat

Feito!

sexta-feira, 21 de outubro de 2016

Entendendo o RAID

O que é RAID ?
O RAID originalmente Redundant Array of Independent Disk (Arranjo Redundante de Discos Independentes) é um sistema de armazenamento composto de diversos discos rígidos individuais, com o objetivo de ganhar segurança e desempenho.
O RAID oferece segurança e confiabilidade por meio da adição de redundância. Se um disco falhar, o outro continua funcionando normalmente e o usuário nem percebe diferença. O administrador é avisado pelo sistema e substitui o disco que falhou. Apesar disso, o RAID não protege contra falhas de energia ou erros de operação ou contra a falha simultânea dos dois discos. Falhas de energia, código errado de núcleo ou erros operacionais podem danificar os dados de forma irrecuperável. Por este motivo, mesmo usando-se o RAID não se dispensa fazer backup por questão de garantia.

Como funciona o RAID ?
O RAID existe dois tipos de arquiteturas que pode ser implementado, via hardware e via software.

Implementação via Hardware:
Controladoras RAID em hardware usam layouts de disco proprietários (e diferentes). Por isso, normalmente não é possível misturar controladoras de fabricantes diferentes. Eles não utilizam recursos do processador. O BIOS - Basic Input/Output System - pode iniciar (dar boot) por ela, e uma integração maior com o driver de dispositivo pode oferecer um melhor tratamento de erros.

Uma implementação de RAID em hardware requer pelo menos uma controladora especialmente dedicada para isso. Em uma estação de trabalho (PC comum) isso pode ser uma placa de expansão PCI, PCI-e ou uma placa integrada à placa-mãe. Controladoras utilizando a maioria dos tipos de drive podem ser usadas - IDE/ATA, Serial ATA, SCSI, SSA, Fibre Channel, e às vezes uma combinação. A controladora e os discos utilizados devem estar isolados. Podem estar conectados diretamente ao computador, ou conectados via SAN. A controladora gerencia os drives e faz os cálculos de paridade necessários pelo nível de RAID escolhido.

A maioria das implementações em hardware proveem cache de leitura e escrita, o que (dependendo da carga de I/O) melhora a performance. Na maioria dos casos, o cache de escrita é não-volátil (protegido por bateria), e portanto, escritas pendentes não são perdidas no caso de uma falha no suprimento de energia. Implementações em hardware promovem performance garantida, não sobrecarregam o processador e podem suportar vários sistemas operacionais, já que a controladora apresentará ao sistema operacional um disco simples

Implementação via Software: 
Na implementação via software, o sistema operacional gerencia o RAID através da controladora de discos, sem a necessidade de um controlador de RAIDs, tornando-a mais barata.

Nesse tipo de implementação, todo o processamento necessário para o gerenciamento do RAID é feito pela CPU. Toda movimentação de dados(leitura e escrita) é feita por uma camada de software que faz a abstração entre a operação lógica (RAID) e os discos físicos, e é controlada pelo sistema operacional.

A configuração do RAID via software é feita pelo sistema operacional, que precisa ser implementado no próprio núcleo a utilização de RAIDs via software. É possível criar RAIDs via software no Mac OS X, Linux, FreeBSD, OpenBSD e no Windows Server. Alternativamente, podem ser criados com algum software especialmente dedicado a manutenção de discos rígidos do fabricante da placa mãe (quando há suporte para RAID, é claro).

Comparação entre as arquiteturas
Ao compararmos RAIDs por software e por hardware percebe-se que os implementados através de software são mais flexíveis que os via hardware. Por outro lado, os primeiros exigem da CPU mais tempo de processamento.

Comparando os dispositivos de blocos, os em software também são flexíveis podendo ser usados em discos inteiros, partições ou outro dispositivo de bloco.

Níveis de RAID
Os níveis de RAID são combinados os discos de diferentes maneiras e serão explicados a seguir:

RAID-Linear:  É uma simples concatenação de partições para criar uma grande partição virtual. 

Desvantagens: Não oferece redundância, isto é, se um disco falhar, a partição combinada irá falhar também.
Não há ganho de desempenho.

RAID-0: É bem parecido ao RAID-Linear, com exceção de os dados serem lidos e escritos em paralelo nos discos, o que aumenta o desempenho.

Vantagens:
  • acesso rápido as informações
  • custo baixo para expansão de memória. 
Desvantagens:
  • caso algum dos setores de algum dos HDs venha a apresentar perda de informações, o mesmo arquivo que está dividido entre os mesmos setores dos demais HDs não terão mais sentido existir, pois uma parte do arquivo foi corrompida, ou seja, caso algum disco falhe, não tem como recuperar; 
  • não é usada paridade.
RAID-1: Esse nível de RAID que implementa o espelhamento de disco Para esta implementação são necessários no mínimo dois discos ou mais desde que seja utilizado sempre um número par. O funcionamento deste nível é simples: todos os dados são gravados em dois discos diferentes; se um disco falhar ou for removido, os dados preservados no outro disco permitem a não descontinuidade da operação do sistema.

Vantagens:
  • caso algum setor de um dos discos venha a falhar, basta recuperar o setor defeituoso copiando os arquivos contidos do segundo disco;
  • segurança nos dados (com relação a possíveis defeitos que possam ocorrer no HD). 
Desvantagens:
  • custo relativamente alto se comparado ao RAID 0;
  • ocorre aumento no tempo de escrita;
RAID-2: O RAID 2 surgiu no final dos anos 80, onde os HDs não possuíam checagem de erros. Assim, pode-se dizer que o RAID 2 é similar ao RAID 0, mas possuindo algoritmos de Hamming ECC, que é a informação de controle de erros, no lugar da paridade. Além disso, pode-se ter várias configurações, como 10 discos normais + 4 discos somente para ECC. Este fato possibilita uma protecção adicional, porém o RAID 2 ficou obsoleto pelas novas tecnologias de disco já possuírem este tipo de correcção internamente. O RAID 2 origina uma maior consistência dos dados se houver queda de energia durante a escrita. Baterias de segurança e um encerramento correto podem oferecer os mesmos benefícios.

Vantagem:
  • usa ECC, diminuindo a quase zero as taxas de erro, mesmo com falhas de energia. 
Desvantagens:
  • hoje em dia, há tecnologias melhores para o mesmo fim.
  • dependendo da configuração e necessidade da empresa, era necessário a mesma quantidade de discos ECC para discos normais, isto é, desperdício de espaço que poderia ser usado para dados. 
RAID-3: O RAID 3 é uma versão simplificada do RAID nível 2. Nesse arranjo, um único bit de paridade é computado para cada palavra de dados e escrito em um drive de paridade. No primeiro momento, pode parecer que um único bit de paridade dá somente detecção de erro, e não correção de erro. Para o caso de erros aleatórios não detectados, essa observação é verdadeira. Todavia, para o caso de uma falha de drive, ela provê correção total de erros de um bit, uma vez que a posição do bit defeituoso é conhecida. Se um drive falhar, o controlador apenas finge que todos os seus bits são 0. Se uma palavra apresentar erro de paridade, o bit que vem do drive extinto deve ter sido um (1), portanto, é corrigido.

A fim de evitar o atraso em razão da latência rotacional, o RAID 3 exige que todos os eixos das unidades de disco estejam sincronizados. A maioria das unidades de disco mais recentes não possuem a opção de sincronização do eixo, ou se são capazes disto, faltam os conectores necessários, cabos e documentação do fabricante.

Vantagens:
  • leitura rápida;
  • escrita rápida;
  • possui controle de erros.

Desvantagem:
  • Montagem difícil via software.
RAID-4: O RAID 4 funciona com três ou mais discos iguais. Um dos discos guarda a paridade (uma forma de soma de segurança) da informação contida nos discos. Se algum dos discos avariar, a paridade pode ser imediatamente utilizada para reconstituir o seu conteúdo. Os discos restantes, usados para armazenar dados, são configurados para usarem segmentos suficientemente grandes (tamanho medido em blocos) para acomodar um registro inteiro. Isto permite leituras independentes da informação armazenada, fazendo do RAID 4 um array perfeitamente ajustado para ambientes transacionais que requerem muitas leituras pequenas e simultâneas.

O RAID 4 assim como outros RAIDs, cuja característica é utilizarem paridade, usam um processo de recuperação de dados mais envolvente que arrays espelhados, como RAID 1. Este nível também é útil para criar discos virtuais de grande dimensão, pois consegue somar o espaço total oferecido por todos os discos, exceto o disco de paridade. O desempenho oferecido é razoável nas operações de leitura, pois podem ser utilizados todos os discos em simultâneo.

Sempre que os dados são escritos no array, as informações são lidas do disco de paridade e um novo dado sobre paridade deve ser escrito para o respectivo disco antes da próxima requisição de escrita ser realizada. Por causa dessas duas operações de I/O, o disco de paridade é o fator limitante do desempenho total do array. Devido ao fato do disco requerer somente um disco adicional para proteção de dados, este RAID é mais acessível em termos monetários que a implementação do RAID 1.

Vantagens:
  • taxa de leitura rápida;
  • possibilidade do aumento de área de discos físicos. 
Desvantagens:
  • taxa de gravação lenta;
  • em comparação com o RAID 1, em caso de falha do disco, a reconstrução é difícil, pois o RAID 1 já tem o dado pronto no disco espelhado;
  • tecnologia não mais usada por haver melhores para o mesmo fim.
RAID-5: O RAID 5 é frequentemente usado e funciona similarmente ao RAID 4, mas supera alguns dos problemas mais comuns sofridos por esse tipo. As informações sobre paridade para os dados do array são distribuídas ao longo de todos os discos do array , ao invés de serem armazenadas num disco dedicado, oferecendo assim mais desempenho que o RAID 4, e, simultaneamente, tolerância a falhas.

Vantagens:
  • maior rapidez com tratamento de ECC;
  • leitura rápida (porém escrita não tão rápida). 
Desvantagem:
  • sistema complexo de controle dos HDs.(discos)
RAID-6: É um padrão relativamente novo, suportado por apenas algumas controladoras. É semelhante ao RAID 5, porém usa o dobro de bits de paridade, garantindo a integridade dos dados caso até 2 dos HDs falhem ao mesmo tempo. Mínimo de 4 HDs para ser implementado. Ao usar 8 HDs de 20 GB cada um, em RAID 6, teremos 120 GB de dados e 40 GB de paridade.

Vantagem:
  • possibilidade falhar 2 HDs ao mesmo tempo sem perdas. 
Desvantagens:
  • precisa de N+2 HDs para implementar por causa dos discos de paridade;
escrita lenta;
  • sistema complexo de controle dos HDs.
Referência
[1] http://www.thegeekstuff.com/2011/11/raid2-raid3-raid4-raid6/

No próximo post, será explicado a configuração do RAID via software no Linux.
Feito!

domingo, 18 de setembro de 2016

Configurando LVM no Debian

O que é LVM ?
O LVM (Logical Volume Manager) é um recurso que permite criar volumes lógicos (um particionamento virtual).

Como o LVM funciona ?
O LVM funciona com os três elementos básicos:

PV (Physical Volume ou Volume Físico): É a definição das partições ou áreas do disco (ou discos) que ficarão disponíveis para serem utilizadas pelo LVM.

VG (Volume Group ou Agrupamento de volumes): É uma subdivisão do PV, algo como uma partição estendida. Pode ser utilizada para criar sistemas de arquivos maiores do que a limitação física de um disco rígido, como por exemplo, uma partição de 2TB em um HD utilizando o MBR (em discos utilizando GPT esta limitação não existe).

LV (Logical Volume ou Volume Lógico): É como se fosse uma partição lógica dentro de uma partição estendida (VG). Esse elemento é uma área de alocação na qual criamos o filesystem. Ao criarmos um volume lógico, recebemos um dispositivo para referenciarmos, ao criar ou manipular, o sistema de arquivos.

Depois de conhecer o LVM e pra que ser serve, podemos seguir os procedimentos de configuração do LVM em seu computador com SO GNU/Linux Debian Jessie (8), mas deve funcionar também nas versões anteriores e futuras do Debian sem problemas.

Instalação do LVM
root@Saitam:# apt-get update
root@Saitam:# apt-get install lvm2

Criação dos Volumes Lógicos
Primeiramente é necessário adicionar pelo menos dois discos no servidor ou computador. Nesse howto foi criado 2 discos de tamanho 8GB cada.

Disco 1
root@Saitam:# cfdisk /dev/sdb
Nesse caso foi criado uma partição única de 8GB do tipo de sistema de arquivos 8e (Linux LVM)

Disco 2
root@Saitam:# cfdisk /dev/sdbc
Nesse caso foi criado uma partição única de 8GB do tipo de sistema de arquivos 8e (Linux LVM)

Com os discos que serão utilizados para volumes lógicos desmontados, será criado o volume físico (PV) como segue:

# pvcreate /dev/sdb1 /dev/sdc1
Physical volume "/dev/sdb1" successfully created
Physical volume "/dev/sdc1" successfully created


Podemos ver o status que foi criado com sucesso
root@Saitam:# pvs
PV VG Fmt Attr PSize PFree
/dev/sdb1 lvm2 --- 8,00g 8,00g
/dev/sdc1 lvm2 --- 8,00g 8,00g


Agora será incluido esses dois volumes físicos em um grupo de volumes chamado saitam
root@Saitam:# vgcreate saitam /dev/sdb1 /dev/sdc1
/proc/devices: No entry for device-mapper found
Volume group "saitam" successfully created


Foi adicionado dois volumes físicos PV em um agrupamento VG com aproximadamente 16GB, como pode ser observado no comando seguinte:
root@Saitam:# vgs
VG #PV #LV #SN Attr VSize VFree
saitam 2 0 0 wz--n- 15,99g 15,99g


Agora podemos criar volumes lógicos LV com o tamanho que desejar. Para criar o volume com 1GB, com LVM1 no agrupamento VG saitam, segue o comando:
root@Saitam:# lvcreate -L1G -n LVM1 saitam
Logical volume "LVM1" created


Podemos verificar o volume criado com o comando seguinte:
root@Saitam:# lvs
LV VG Attr LSize Pool Origin Data% Meta% Move Log Cpy%Sync Convert
LVM1 saitam -wi-a----- 1,00g


Usando Volumes Lógicos
Com os passos acima executado corretamente, podemos acessar o volume lógico com o nome do grupo dado no /dev/nome-volume-logico

root@Saitam:# ls -la /dev/saitam/
total 0
drwxr-xr-x 2 root root 60 Set 17 16:51 .
drwxr-xr-x 17 root root 3120 Set 17 16:51 ..
lrwxrwxrwx 1 root root 7 Set 17 16:51 LVM1 -> ../dm-0

Assim podemos formatar o /dev/nome-volume-logico/LVM1 como se fosse uma partição no mesmo HD
root@Saitam:# mkfs.ext4 /dev/saitam/LVM1
mke2fs 1.42.12 (29-Aug-2014)
Creating filesystem with 262144 4k blocks and 65536 inodes
Filesystem UUID: 16d941fa-314b-4911-894e-d44576773ecf
Superblock backups stored on blocks:
32768, 98304, 163840, 229376
Allocating group tables: done
Writing inode tables: done
Creating journal (8192 blocks): done
Writing superblocks and filesystem accounting information: done


Criaremos agora um ponto de montagems para o volume lógico, segue os passos:
root@Saitam:# mkdir /mnt/lvm
root@Saitam:# mount -t ext4 /dev/saitam/LVM1 /mnt/lvm


Editar o arquivo /etc/fstab para o ponto de montagem pode montar no boot, adaptando para o nome do volume grupo que foi dado
root@Saitam:# vim /etc/fstab
Incluir a linha abaixo no final do arquivo
/dev/saitam/LVM1 /mnt/lvm ext4 defaults 0 0

ESC +:x (salva e sai do editor Vim)

Redimensionando o tamanho do LVM
Podemos aumentar o volume lógico, com os procedimentos abaixo:
root@Saitam:# umount /mnt/lvm/
root@Saitam:# lvextend -L +6G /dev/saitam/LVM1
Size of logical volume saitam/LVM1 changed from 1,00 GiB (256 extents) to 7,00 GiB (1792 extents).
Logical volume LVM1 successfully resized

root@Saitam:# e2fsck -f /dev/saitam/LVM1
e2fsck 1.42.12 (29-Aug-2014)
Pass 1: Checking inodes, blocks, and sizes
Pass 2: Checking directory structure
Pass 3: Checking directory connectivity
Pass 4: Checking reference counts
Pass 5: Checking group summary information
/dev/saitam/LVM1: 11/65536 files (0.0% non-contiguous), 12635/262144 blocks


root@Saitam:# resize2fs /dev/saitam/LVM1
resize2fs 1.42.12 (29-Aug-2014)
Resizing the filesystem on /dev/saitam/LVM1 to 1835008 (4k) blocks.
The filesystem on /dev/saitam/LVM1 is now 1835008 (4k) blocks long.

root@Saitam:# mount -t ext4 /dev/saitam/LVM1 /mnt/lvm

Verifique o status do volume lógico se aumentou de acordo, lembra que tinha 1GB e foi adicionado 6GB
root@Saitam:# df -h V
/dev/mapper/saitam-LVM1 6,9G 2,3M 6,5G 1% /mnt/lvm

Considerações finais

O LVM é um recuso que possui muita flexibilidade ao administrador de sistemas em seu servidor e até no seu próprio computador.

Assim é possível, adicionar mais discos rígidos no computador e aumentar o tamanho do volume sem que haja perda de dados.

Feito!

quarta-feira, 7 de setembro de 2016

O perfil do profissional Linux

Especialistas em treinamento e certificações apontam que o caminho para quem quer trabalhar com Linux pode ser árduo, mas compensa

Procura-se um profissional com visão generalista para o mundo da infraestrutura da informática, que saiba integrar plataformas diversas, como Unix, Linux, Windows, que seja flexível e dedicado ao estudo aprofundado dos principais sistemas em uso. Ser um profissional da área de informática atualmente é algo desafiador, pois integração é a palavra-chave no mercado de trabalho. Muitas empresas não mudam totalmente os seus sistemas da noite para o dia, mas sim, adaptam o hardware que possuem para as demandas de informação específicas para a sua atividade-fim. Soluções que mesclam softwares livres com proprietários em plataformas diferentes tornam-se comuns. E o profissional de informática está preparado para esse cenário?

Na opinião de especialistas em treinamento e consultores profissionais, o mercado de trabalho traz algumas exigências. Ser formado em curso universitário reconhecido pelo MEC, por exemplo, é uma delas. "Dependendo da empresa, o nível superior é fundamental para a sua admissão", comenta Valério Kikuchi, diretor geral da Utah Consultores, empresa de São Paulo que oferece treinamento e soluções na área de informática e que já treinou mais de 7.000 alunos de empresas como a Citibank, IBM Brasil, UOL, entre outras. Empresas de consultoria, salienta Kikuchi, têm encontrado dificuldades de colocar profissionais não-bacharéis no mercado. "Algumas empresas já pedem os currículos dos consultores e se não forem formados, poderão ser indeferidos nos projetos", explica.

Para o diretor presidente da Impacta Tecnologia, Célio Antunes de Souza, independentemente de o profissional ter nível superior ou não, o fundamental é conhecer todas as características e detalhes mais importantes do sistema operacional, seja ele qual for. Para Antunes, isso se deve à forma como o Linux é utilizado nas empresas. "Os ambientes são heterogêneos, mantendo diversos sistemas operacionais, de fabricantes e versões diferentes", diz. O exemplo de Linus Torvalds mostra que nem sempre é preciso ter um diploma para criar um sistema operacional. Ele ainda cursava ciência de computação na Universidade de Helsinque quando resolveu criar um sistema alternativo, que deu origem ao Linux. "O importante não é apenas o domínio da informação, mas sim a capacidade de olhar algo com olhos de quem quer aprender, ou seja, desde que a pessoa tenha a vontade de aprender, ela terá uma facilidade muito grande para dominar o Linux", declara Pedro Matheus, consultor da Harvest Consultoria, de São Paulo.

O caráter comunitário do Linux, com seus milhares de programadores e usuários em todo o mundo, que trocam informações constantemente e resolvem problemas por meio da Internet, tudo isso realmente facilita muito o aprendizado, mas de nada adianta se não dominar o idioma de Shakespeare. "Todo o rico material para Linux e os melhores cursos estão em inglês e essa é a língua do mundo dos negócios", complementa Valério Kikuchi. 

O mercado de trabalho para o profissional de informática com conhecimento em Linux ainda é atraente, pois segundo Kikuchi, há poucos realmente capacitados para as necessidades. No entanto, as coisas não são tão fáceis como parecem. Na opinião do presidente da Impacta, Célio Antunes, apesar da grande oferta de treinamentos especializados em todas as áreas do Linux, nem todos os alunos estão aptos a preencher a demanda do mercado de trabalho. "Isso acontece ou porque não conseguem absorver os conhecimentos necessários ou, quando absorvem, ainda não têm a experiência exigida pelas empresas", justifica.

Apesar do fato de que hoje em dia ser especializado em Linux seja uma grande vantagem no mercado da informática, o fator pessoal é ainda predominante na hora de escolher aquela ou outra pessoa. "Se dedicar ao estudo mais profundo do sistema e procurar a cada dia mais se especializar em um determinado assunto é um diferencial que acredito que nunca será superado", diz Antunes.

Desktop é desafio
A rotatividade também é algo importante a ser analisada, apontam especialistas. O diretor da Utah, Valério Kikuchi conta que nas décadas de 70 e 80, o mercado de trabalho em informática já tinha uma rotatividade alta que ficou ainda maior com o surgimento de uma nova forma de trabalho: a consultoria. "Sem o vínculo da CLT, o pessoal da informática foi atrás de contratos, alguns apenas por dinheiro e outros por trabalhos mais desafiadores", diz. A partir do final dos anos 80, com a ampliação da parafernália informática (equipamentos, softwares e periféricos) e de seus fornecedores, os trabalhos de consultoria cresceram e favoreceram as mudanças constantes de local de trabalho e, inclusive, empresas. Muitas delas acabam contratando ex-funcionários da concorrência, acirrando a disputa pelos profissionais com mais conhecimentos.
Sobre o assunto certificação, Kikuchi diz que tem sido procurado por empresas de vários portes que estão migrando toda, ou parte, de sua infraestrutura operacional para o Linux. De acordo com ele, as empresas querem fazer a certificação para "ter na mão" a sua nova infraestrutura. "Com o Linux, ela fica mais estável, mas requer uma nova especialização que admite poucos erros de suporte". No que se refere ao desktop, Kikuchi afirma que poucas empresas já decidiram mudar para o sistema operacional do pingüim. "Essa é ainda a última fronteira para o Linux", completa.

Conhecimento profundo
A complexidade do trabalho em informática valorizou acentuadamente os gerentes cujos salários, de acordo com estimativa do diretor presidente da Impacta, Célio Antunes, podem ser superiores a R$ 5.000. Para ele, os maiores empregadores para os profissionais capacitados em Linux são empresas de telecomunicações,desenvolvimento de software e provedores de Internet. "Profissionais com nível gerencial necessitam ter um conhecimento mais profundo do sistema, devem saber o que pode e o que não pode ser feito com o Linux e ter experiência nas áreas em que atuam", explica. Para Antunes, boa parte dos custos de projetos com Linux pode ser reduzida com o apoio dessas pessoas. Na hora de preencher um currículo, alguns pontos são importantes, aponta Antunes. O primeiro deles é que todo e qualquer tipo de treinamento realizado deve ter sido feito por profissionais da área. "Outros cursos de especialização devem ser citados, principalmente os que têm uma relação direta com o objetivo a ser alcançado, além das experiências anteriores diretamente ligadas ao Linux", destaca.

Funções do profissional Linux
Muitas empresas que passam a adotar o Linux em suas redes estão à procura de pessoas especializadas, que podem ser contratadas ou até trabalhar como prestadoras de serviços. As funções mais conhecidas são as de administrador de redes, especialista em segurança, desenvolvedores e profissionais de suporte técnico/help-desk. Para saber mais sobre cada uma dessas funções, a Revista do Linux entrevistou quatro profissionais que trabalham na maior distribuição Linux na América Latina, a Conectiva.

Desenvolvedores
O programador do projeto KDE e colaborador da Revista do Linux, Roberto Teixeira, explica que a principal função do desenvolvedor de software é encontrar soluções para problemas. As ferramentas que um desenvolvedor deve dominar dependem muito dos projetos em que ele esteja envolvido. "Um programador C precisa dominar o compilador C, o debugger e deve dominar um bom editor. O importante é conhecer a lógica dos sistemas para ser um desenvolvedor", complementa. Para Teixeira, ninguém conhece tudo sobre desenvolvimento de software. "Muita gente tenta aprender uma linguagem de programação sem realmente aprender a programar. O que é importante é a lógica", diz. A preguiça definitivamente deve ficar longe de todo desenvolvedor de software, aponta Teixeira. Para ele, em programação nunca se acha tudo "mastigadinho" e pronto, como em outras áreas. "Na programação, o desenvolvedor deve ter a capacidade de abstrair informações e ir atrás de soluções". Os livros, frisa Teixeira, podem, no máximo, ser boas referências, mas para ele nunca existiu nem jamais existirá um livro que ensine alguém a ser programador.

Qualidades necessárias para ser um desenvolvedor
capacidade de abstração, curiosidade, paciência, persistência.
"É importante não ter vergonha de perguntar a quem sabe mais, mas também não se pode perguntar algo sem antes procurar descobrir, se não, a pessoa não aprende".
Roberto Teixeira - desenvolvedor do KDE.

Especialistas em segurança
Há muitas coisas que o especialista de segurança pode fazer. Tudo depende da função de cada um deles em uma empresa (ou até mesmo como autônomos). Eles podem auditar programas e sistemas, próprios ou de terceiros, podem realizar testes de segurança de redes (própria ou de terceiros), também chamados de testes de penetração, corrigir os problemas de segurança encontrados ou se responsáveis pela segurança da rede da empresa onde trabalham.
Para o especialista em segurança da Conectiva, Andreas Hasenack, que também já colaborou com a seção Segurança da Revista do Linux, um bom especialista em segurança deve, antes de tudo, conhecer em detalhes todos os sistemas operacionais envolvidos em seu trabalho.
"Precisa conhecer protocolos de rede e linguagens de programação, ser criativo e imaginar o que um atacante poderia fazer", afirma. Para Hasenack, o especialista deve usar, preferencialmente suas próprias ferramentas e scripts. "Acreditar piamente no que um programa te diz, sem saber o que o programa está exatamente fazendo e como está chegando àquele resultado, é pedir para ficar com uma falsa sensação de segurança", comenta.
Para aprender tudo o que sabe sobre segurança, Hasenack já perdeu a conta de quantos livros, listas de discussão, manpages e artigos já leu. "Além de ler, ler e ler, o especialista em segurança deve experimentar as ferramentas, analisar, por exemplo, o tráfego gerado por elas e entender como funcionam. Se não gostar de ler no computador, imprima e encaderne", explica.

O que um especialista de segurança deve estudar?
esquemas de autenticação, netfilter, rootkits, criptografia, capabilities e sistema de privilégios e permissões.
Bugs mais conhecidos que sempre se repetem:
buffer overflows, erros na formatação de strings, condições de corrida com arquivos temporários, injeção de comandos SQL em consultas, problemas de escape de caracteres perigosos (Shell, Perl, PHP, o próprio SQL) e outros.
"O importante é ler, ler e ler. Ah, e ler. Se não gostar de ler no computador, imprima e encaderne".
Andreas Hasenack, especialista em segurança da Conectiva.

Administradores de redes
Quando se monta uma rede de informática, o administrador de redes pode trabalhar em conjunto com o especialista em segurança para elaborar a estrutura da rede e políticas de acesso que melhor se ajustem à realidade da empresa. "O administrador participa diretamente na montagem dessa estrutura, tanto fazendo quanto organizando os técnicos envolvidos na montagem", explica o administrador da rede da Conectiva, Moisés José Gonçales dos Santos. Ele aponta que, depois de ter a estrutura montada e em funcionamento, o papel básico do administrador é mantê-la funcionando devidamente, e, para isso, é necessário um monitoramento constante do tráfego, dos serviços e dos servidores da rede.
Outro item importante na hora de administrar uma rede é o cuidado constante com a sua segurança, por meio de atualizações de segurança, boas políticas de "firewalling" e detecção de acessos indevidos. O administrador também pode gerenciar as contas dos usuários, logins, senhas e e-mails. A pesquisa e implantação constante de novas tecnologias também são fundamentais no trabalho do administrador. "Visamos sempre melhorar a estrutura da rede e os serviços presentes nela", considera.
Para Moisés, a Internet é a melhor fonte de pesquisa disponível. "Tudo que é novo e está sendo explorado se encontra em sites especializados, com reviews de outras pessoas que estão trabalhando naquilo", observa. Ter um bom embasamento sobre protocolos de rede, conceitos de segurança em rede, serviços e inclusive cabeamento físico são conhecimentos necessários que podem ser obtidos em cursos específicos voltados para administração de redes. Livros também podem ajudar a vida do profissional, principalmente aqueles sobre protocolos como TCP/IP (para entender a base da rede). Até os manuais de roteadores e switches permitem aos administradores perceber e usufruir tudo que esses equipamentos podem fazer. "Na parte de servidores e serviços, a documentação que os acompanha normalmente é suficiente para colocá-lo em funcionamento, mas caso falte alguma coisa, é sempre possível recorrer à Internet e buscar casos em que foram encontradas as mesmas dificuldades", finaliza.

Analista de Suporte Técnico
"O suporte técnico é uma área agradável e infernal ao mesmo tempo, apesar de eu ser suspeito, pois gosto muito do meu trabalho". A afirmação é do coordenador de suporte da Conectiva, Marcelo Martins. Os profissionais de suporte técnico prestam auxílio ou resolvem os problemas decorrentes da instalação, detalhes de configuração e até na detecção de bugs, que são repassados às equipes de desenvolvimento, para que sejam corrigidos. "Ao receber a correção, o suporte deve instalá-la e verificar se solucionou o problema", explica. De acordo com Martins, a rotina desses profissionais é puxada, e quem quiser se aventurar na área tem que se habituar com horários estranhos, suporte 24 horas e atendimentos emergenciais. "Afinal, somos quase um médico de micro", comenta.
Um profissional de suporte Linux deve dominar plenamente o sistema operacional, sua administração e configuração, além de ter conhecimentos básicos de programação no caso de alguma recompilação do sistema para arrumar um problema. "Quem trabalha no suporte deve ter o domínio das ferramentas de pesquisa, saber analisar logs do sistema", aponta Martins. Outra dica que ele aponta para aqueles que querem se aventurar na área é manter-se atualizado com a leitura de sites de notícias em Linux, tutoriais e conversas com os colegas de suporte ou desenvolvimento. "Foi pela Internet que consegui a maioria dos Howtos, artigos e notícias para a minha formação em Linux. Há também as listas de discussão. Afinal, o Linux é uma comunidade e todos procuram ajudar", assinala.
Martins enumera as principais tarefas para se tornar um bom profissional de suporte. "Pesquisar na Internet, participar de listas de discussões e fóruns, ter ao menos uma máquina para testes, reinstalações e recompilações, ser persistente, pois muitas coisas se escondem nos detalhes". Ele explica que, embora a comunidade Linux ajude, as pessoas não devem esperar as "receitas de bolo" ou que expliquem tudo detalhadamente. "É necessário esforço para aprender. Se pegar tudo pronto, o profissional não cresce", aponta. Para ele, por mais que a profissão de técnico de suporte tome tempo, esse profissional deve sempre encontrar um meio para manter-se atualizado, pois o mundo Linux é muito rápido em suas mudanças e novidades.

Tipos de suporte
Help desk remoto: o atendimento é feito por e-mail e telefone, o suporte é considerado passivo, pois depende da demanda do cliente ao entrar em contato para a resolução de um problema. O profissional de suporte usa, nesse caso, a técnica do repasse do conhecimento, por meio do qual vai informando para o cliente o que ele deve fazer para que seu problema seja resolvido.
Atendimento On-Site: o profissional de suporte vai até o cliente para resolver o problema, sendo que nesse caso, não é raro que sejam gastas noites e finais de semana com o suporte técnico debruçado em um determinado problema.
Resolução remota: o suporte técnico conecta-se (ssh, dial-up, etc.) à máquina do cliente para resolver o problema.
Suportes de segundo nível: o profissional atende outros técnicos para auxiliar na solução de problemas, sendo que nesses casos os problemas são complexos e exigem alto conhecimento do profissional.
"O mais importante é ser muito bom em relações humanas, pois no suporte nem sempre mexemos com máquinas, mas temos que tratar com um cliente, um outro técnico e, muitas vezes, nosso sucesso depende mais dessa relação do que do trabalho em si".
Marcelo Martins - Coordenador do Suporte Técnico da Conectiva

Rodrigo Asturian - asturian@RevistaDoLinux.com.br

domingo, 28 de agosto de 2016

Blog RikerLinux

Desta vez venho apresentar um blog parceiro do Mundo da Computação Integral, um blog destinado ao público de usuários da distribuição Fedora e demais distros que usam pacotes RPM, com diversos tutoriais de ferramentas para customização no desktop, facilitando o uso diário nas tarefas diárias no computador com a excelente distro Fedora.

Utiliza uma linguagem clara com boa didática para quem esta iniciando no mundo Linux.

Então fica a indicação desse excelente blog, acesse clicando no link
Feito!

terça-feira, 23 de agosto de 2016

Instalando e Configurando Servidor Openfire e Cliente Spark no Debian e CentOS

O que é Openfire ?
Openfire é um servidor de colaboração em tempo real (RTC) licenciado sob a Licença Open Source Apache. Ele usa o protocolo aberto apenas amplamente adotado para mensagens instantâneas, XMPP (também chamado Jabber). Openfire é incrivelmente fácil de configurar e administrar, mas oferece segurança sólida e desempenho. [1]
O que é Spark ?
Spark é um Open Source, multi-plataforma cliente IM otimizada para empresas e organizações. Ele apresenta suporte embutido para chat em grupo, integração de telefonia, e uma forte segurança. Ele também oferece uma ótima experiência do usuário final com vários recursos. Combinado com o servidor Openfire, Spark é a alternativa mais fácil e melhor para a utilização de redes de mensagens instantâneas públicas un-secure. [2]
Qual é a vantagem do Openfire em conjunto com o Spark ?
Ferramenta de comunicação instantânea corporativa interna, em substituição do Lync da Microsoft.
  • Todas as conversas são gravadas e pode ser pesquisado por usuário ou palavra chave.
  • Mostra o tempo de duração de cada conversa.
  • Fazer conferência
  • Criar grupo
Depois de conhecer o Openfire e pra que ser serve, podemos seguir os procedimentos de instalação e configuração do Openfire em seu servidor GNU/Linux Debian ou CentOS/RHEL.
Observação: Testado no GNU/Linux Debian 8 (Jessie) / CentOS 6.7 como servidor para o Openfire na versão 4.0.3 e o Windows 7 Professional e Debian como cliente para o Spark na versão 2.7.7 até a data de publicação deste post.
No Debian
Atualizando o repositório de pacotes
# apt-get update
Instalando os pacotes pré-requisitos necessários
# apt-get install apache2 libmysqlclient15-dev mysql-server php5 php5-gd php5-mysql php5-curl libmysql-java default-jre-headless

No RHEL/CentOS
Atualizando o repositório de pacotes
# yum update
Instalando os pacotes pré-requisitos necessários
# yum install httpd mysql-server mysql-devel php php-mysql php-gd
Startar o serviço do Apache
# systemctl start httpd.service

Criando o banco de dados openfire no MySQL
# mysql_install_db
# mysql -u root -p
Enter password: < digite a senha de root que foi definida na instalação do MySQL >
mysql> create database openfire character set utf8;

Criar o usuário openfireuser para o banco openfireuser
mysql> GRANT ALL PRIVILEGES ON *.* TO openfireuser@localhost IDENTIFIED BY 'senha_openfireuser' WITH GRANT OPTION;
Query OK, 0 rows affected (0.00 sec)
mysql> quit


Download do Openfire
No Debian
$ wget http://www.igniterealtime.org/downloadServlet?filename=openfire/openfire_4.0.3_all.deb -O openfire_4.0.3_all.deb
No RHEL/CentOS
$ wget http://www.igniterealtime.org/downloadServlet?filename=openfire/openfire-4.0.3-1.i386.rpm -O openfire-4.0.3-1.i386.rpm

Instalação do Openfire
No Debian
# dpkg -i openfire_4.0.3_all.deb
No RHEL/CentOS
# rpm -i openfire-4.0.3-1.i386.rpm

Após executar o pacote openfire_4.0.3_all.deb no Debian ou openfire-4.0.3-1.i386.rpm no RHEL/CentOS, acesse no browser - http://IPSERVIDOR:9090

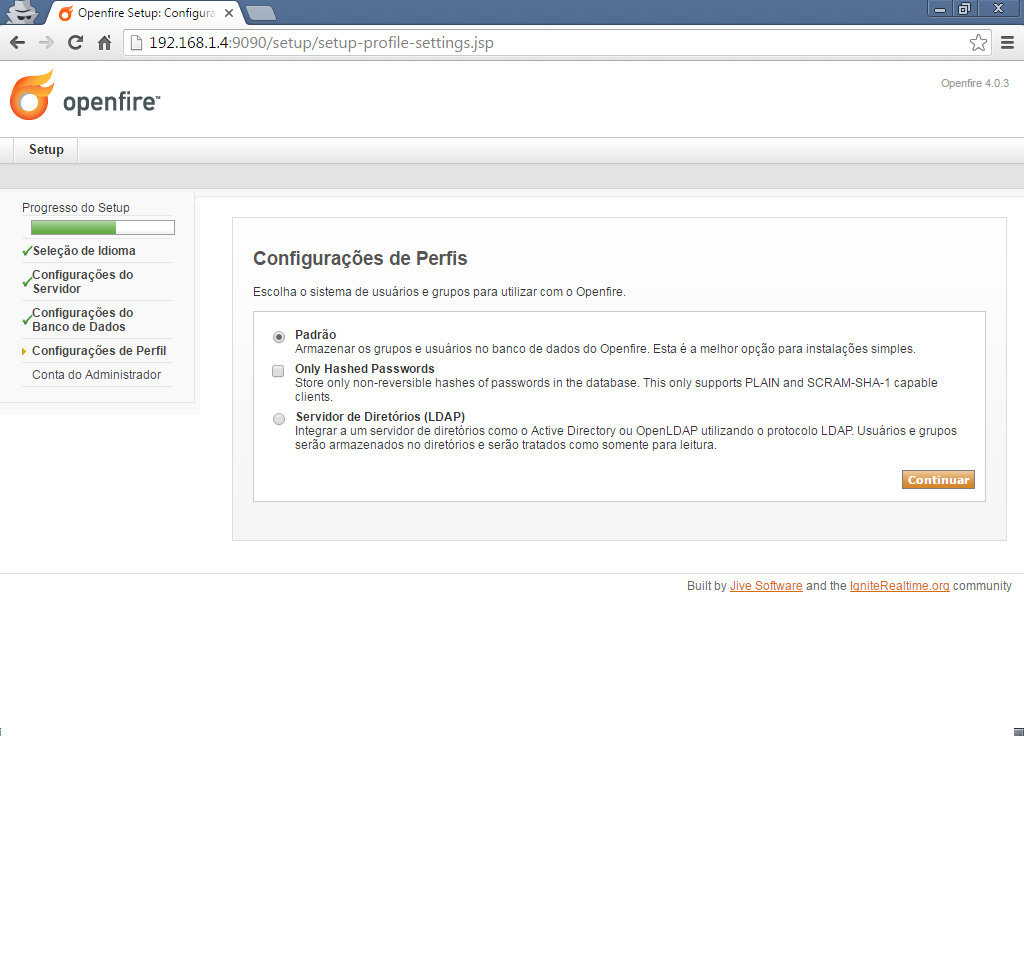
Segue os procedimentos dos screenshots abaixo:
Selecione o idioma que deseja instalar o Openfire e clique no botão Continuar
Coloque o seu domínio e clique no botão Continuar

Marque o radio button Conexão Padrão do Banco de Dados e clique no botão Continuar

Configuração do banco de dados MySQL com Openfire
Predefinições do Driver de Banco de Dados: MySQL.
Classe do Driver JDBC: com.mysql.jdbc.Driver
URL do banco de dados: jdbc:mysql://127.0.0.1:3306/openfire?rewriteBatchedStatements=true
Nome do Usuário: openfireuser
Senha: (criada para o usuário openfireuser)
Minimum Connections: 5
Maximum Connections: 25
Tempo de expiração da Conexão: 1.0


Marque o radio button a opção Padrão e clique no botão Continuar
Defina uma senha para o administrador do Openfire e clique no botão Continuar

Pronto. Clique no botão Logue-se no controle da administração com dados: admin e a senha que criou para o admin

Acesse como admin e a senha que definiu para o admin

Cria um usuário e uma senha default para um cliente que será usado no Spark na conexão com o Openfire


Com o Openfire instalado e configurado corretamente, conforme os procedimentos acima, precisamos instalar o Spark como cliente do Openfire.
O Spark tem disponível para os SOs Windows, Linux e MacOS, o site para download é http://www.igniterealtime.org/downloads/

Existem outros clientes do Openfire também, como pode observar no site, mas nesse Howto será utilizado o Spark, porém você pode usar outro se preferir.
Basicamente para conectar o cliente no servidor Openfire, será solicitado o IP do servidor, o usuário e a senha.
Spark Client no Windows, segue o padrão convencional de instalação de software for Windows: Next, Next e Finish
Spark Client no Linux (qualquer distro)
$ http://www.igniterealtime.org/downloadServlet?filename=spark/spark_2_7_7.tar.gz
$ tar -xzvf spark_2_7_7.tar.gz
$ cd Spark
$ ./Spark
Se preferir depois pode adicionar um atalho no menu do gerenciador de Janelas que utiliza na distro Linux
Ao abrir o Spark, digite o usuário, senha e o IP do servidor Openfire, e clicar no Login.
Caso esteja navegando na Internet por meio do Proxy, clica no botão Avançado, segue:
Marcar o checklist Usar Proxy
Selecionar o tipo de protocolo do Proxy
Endereço IP do servidor Proxy
Porta do servidor Proxy
Usuário e senha que utiliza para autenticar no servidor Proxy
Clica no botão OK.
O modo de usar o Spark Client é bem similar ao antigo MSN, podendo adicionar membros no contatos e conversar entre si.

Cliente Spark conectando com o Servidor Openfire no usuário e senha criado

Cliente Spark Linux e Windows conectados no Servidor Openfire
Veja o exemplo de conversa no screenshot abaixo:

Referências
[1] http://www.igniterealtime.org/projects/openfire/index.jsp

[2] http://www.igniterealtime.org/projects/spark/index.jsp
Feito!